웹 크롤링 파이썬, 도구와 수집 예제
웹 크롤링 파이썬으로 시작할 때 어떤 라이브러리를 고르면 좋을까요? 정적·동적 페이지별 도구, HTML 추출 예제, robots.txt와 요청 간격, 공식 API 검토 순서를 정리합니다.
안녕하세요. 사랑받는 IT 프로덕트의 첫걸음, 똑똑한개발자입니다.
오늘의 인사이트 요약
웹 크롤링은 링크를 따라 페이지를 모으는 일이고, 스크래핑은 그 안에서 필요한 값만 꺼내는 일입니다.
웹 크롤링 파이썬 라이브러리는 정적 페이지면 requests와 BeautifulSoup, 동적 페이지면 Playwright, 대량 수집이면 Scrapy입니다.
돌리기 전에 robots.txt와 이용약관을 보고, 공식 API가 있으면 API부터 씁니다.
웹 크롤링은 링크를 따라 페이지를 수집하는 작업이고, 스크래핑은 페이지에서 필요한 데이터를 추출하는 작업입니다. 파이썬에서는 페이지가 데이터를 제공하는 방식에 따라 도구를 고릅니다. 오늘은 웹 크롤링 파이썬 라이브러리와 수집 예제, 요청 전에 확인할 조건을 정리해보겠습니다.
웹 크롤링 뜻, 스크래핑과 무엇이 다를까
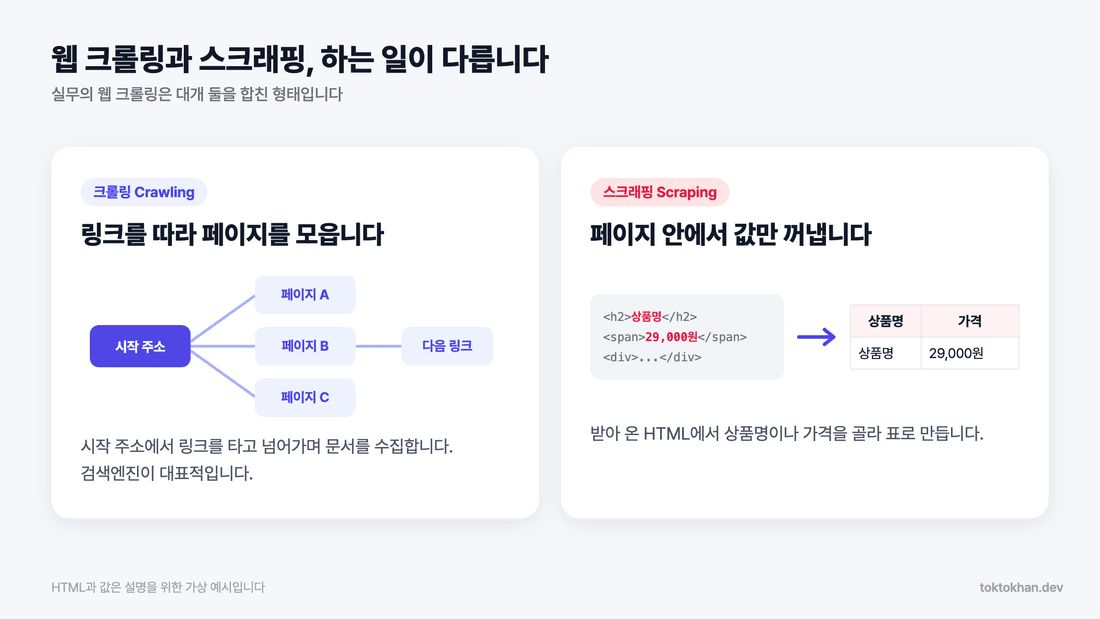
크롤링은 링크를 따라가며 페이지를 모읍니다.
검색엔진처럼 시작 주소에서 링크를 타고 넘어가며 문서를 쌓습니다.
스크래핑은 그 페이지 안에서 값만 꺼냅니다.
받아 온 HTML에서 상품명이나 가격을 골라 표로 옮깁니다. 실무에서는 두 작업을 함께 크롤링이라고 부르기도 합니다.
웹 크롤링 파이썬 라이브러리는 페이지 성격으로 고릅니다
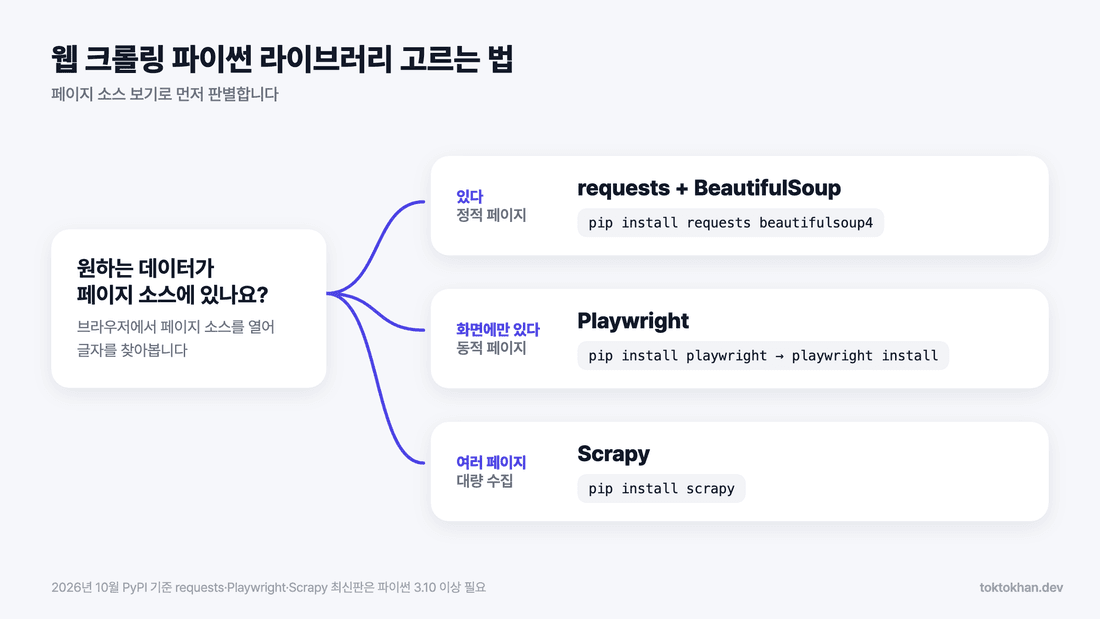
설치할 버전이 지원하는 Python 버전을 먼저 확인합니다. 패키지는 프로젝트 가상환경 안에 설치하면 다른 작업과 구분하기 편합니다.
라이브러리 | 맞는 상황 | 설치 |
|---|---|---|
requests + BeautifulSoup | HTML에 데이터가 바로 있는 정적 페이지 |
|
Playwright | 자바스크립트로 그려지는 동적 페이지 |
|
Scrapy | 여러 페이지를 반복해 모으는 대량 수집 |
|
어느 쪽인지는 페이지 소스 보기로 가립니다.
원하는 글자가 소스에 있다면 requests로 충분합니다. 화면에만 보인다면 공식 API가 있는지 확인하고, 브라우저 렌더링이 필요한 경우 Playwright를 검토합니다.
웹 크롤링 파이썬 예제, 제목과 링크 추출하기
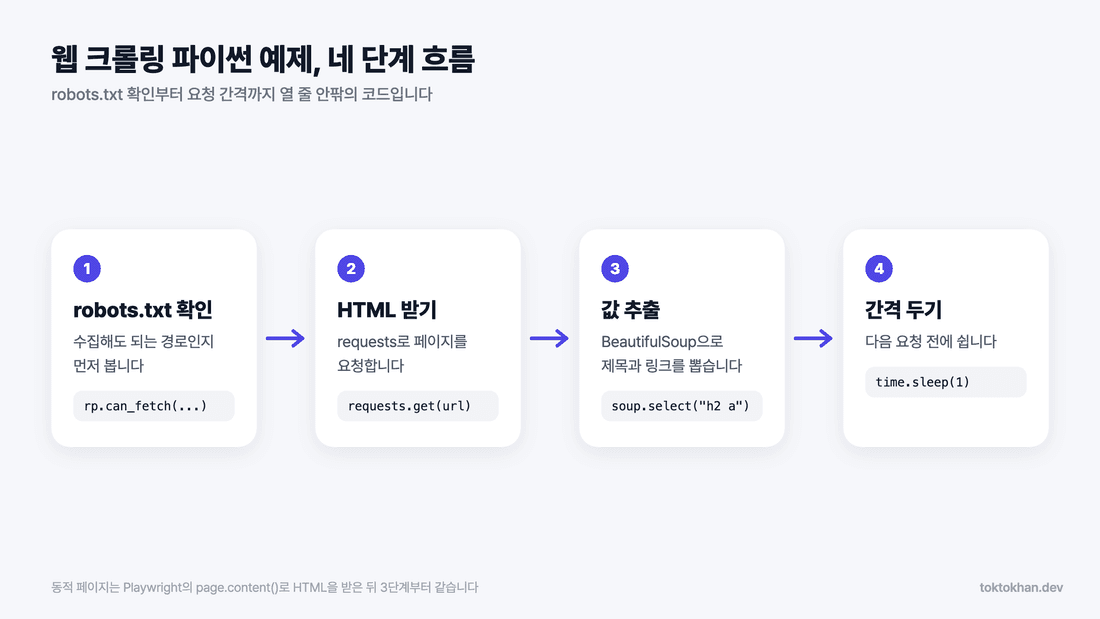
아래는 허용된 사이트의 목록에서 제목과 링크를 뽑는 설명용 예제입니다. 주소와 CSS 선택자는 가상 값입니다. robots.txt를 가져오지 못하거나 허용 여부가 불분명하면 수집을 중단하도록 작성했습니다.
import requests
from bs4 import BeautifulSoup
from urllib.robotparser import RobotFileParser
from urllib.parse import urljoin

url = "https://example.com/news"  # 허용된 대상 주소로 바꿉니다.
agent = "my-crawler"
robots_url = urljoin(url, "/robots.txt")
robots = requests.get(robots_url, timeout=10)
robots.raise_for_status()  # 이 예제는 robots.txt 조회 실패 시 중단합니다.
rp = RobotFileParser()
rp.parse(robots.text.splitlines())
if not rp.can_fetch(agent, url):
    raise RuntimeError("robots.txt에서 허용하지 않은 경로입니다.")
res = requests.get(url, headers={"User-Agent": agent}, timeout=10)
res.raise_for_status()
soup = BeautifulSoup(res.text, "html.parser")
for a in soup.select("h2 a[href]"):
    print(a.get_text(strip=True), urljoin(url, a["href"]))
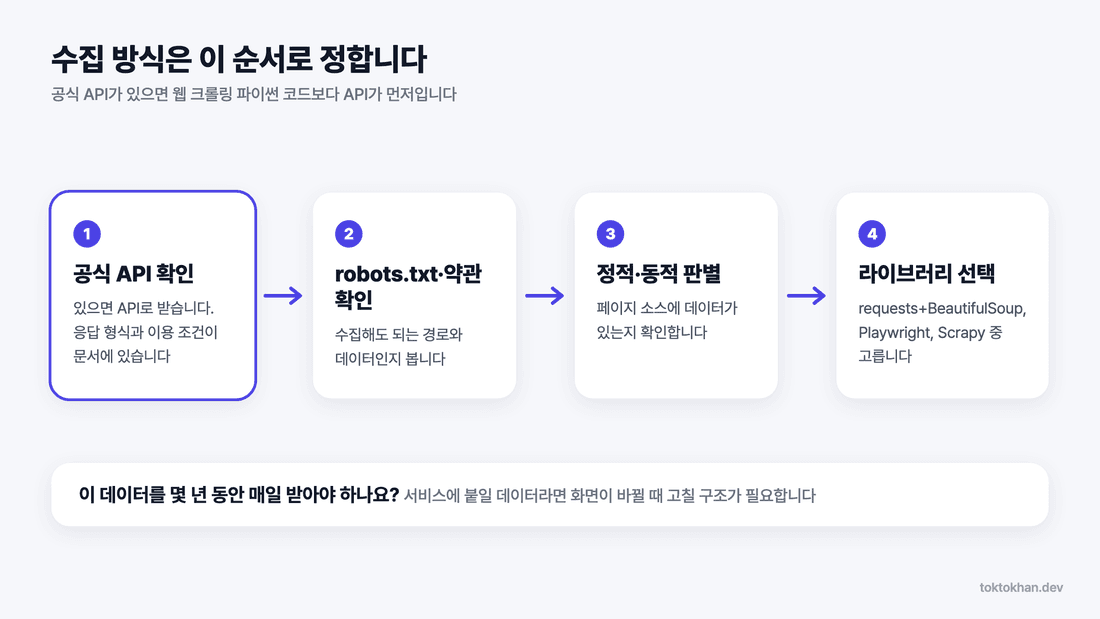
이 예제는 페이지 한 개만 요청합니다. 여러 주소를 반복할 때는 요청 사이 간격과 재시도 상한을 별도로 두고, 429 응답의 Retry-After 안내를 따릅니다. 제공 흐름도는 수집 절차를 간략히 보여 줍니다.
동적 페이지라면 HTML만 Playwright로 받으면 됩니다.
대상 요소가 표시될 때까지 기다린 다음 page.content()로 HTML을 받으면 BeautifulSoup으로 같은 방식으로 추출할 수 있습니다.
웹 크롤링 전에 지켜야 할 세 가지
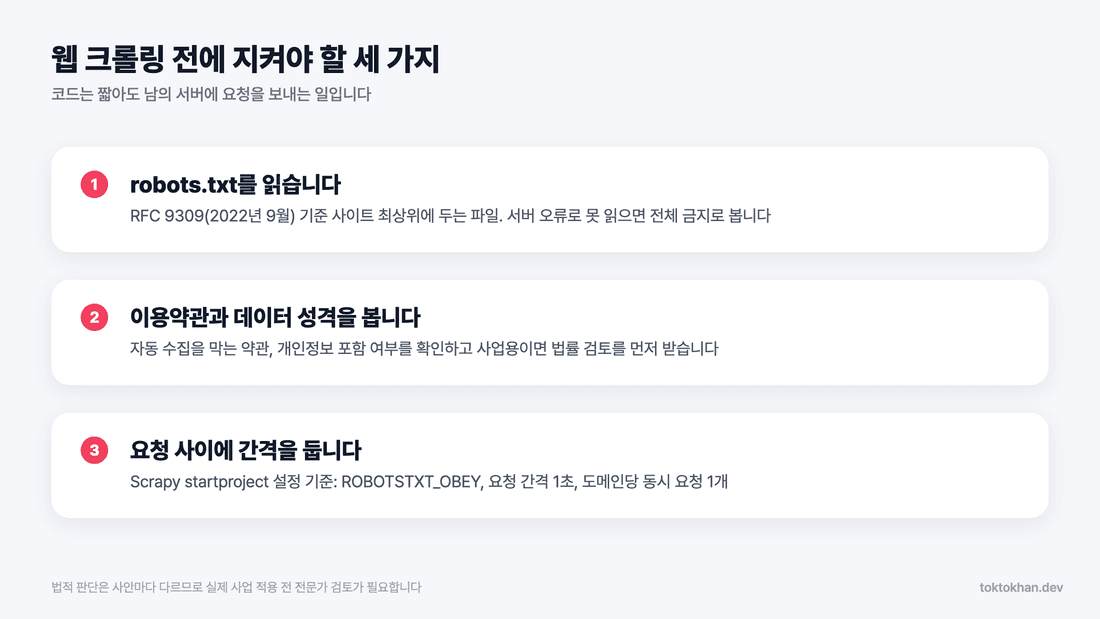
첫째, robots.txt를 읽습니다.
RFC 9309는 2022년 9월에 나온 표준으로, robots.txt를 사이트 최상위에 두도록 정합니다. 접근 권한 장치는 아니라고 밝히면서도 서버 오류로 파일을 못 읽으면 전체 금지로 보라고 합니다.
둘째, 이용약관과 데이터 성격을 봅니다.
자동 수집과 데이터 재사용 조건을 확인합니다. robots.txt에서 허용한 경로라도 이용약관이나 개인정보 처리 기준을 대신 충족하는 것은 아닙니다. 사업에 사용할 데이터라면 수집 범위와 이용 권한을 먼저 검토합니다.
셋째, 요청 사이에 간격을 둡니다.
scrapy startproject로 프로젝트를 만들면 Scrapy가 설정에 ROBOTSTXT_OBEY, 요청 간격 1초, 도메인당 동시 요청 1개를 넣어 둡니다. 버전별 생성 설정을 확인하고 대상 사이트의 안내와 응답 상태에 맞춰 간격을 조정합니다. 1초가 모든 사이트에서 허용되는 기준은 아닙니다.
공식 API가 있으면 API가 먼저입니다
공식 API는 화면 구조와 별도로 데이터 형식과 이용 조건을 문서로 제공합니다. 버전 변경이나 지원 종료는 따로 확인해야 합니다. 공공 데이터라면 저희가 앞서 쓴 공공데이터포털 API 사용법부터 보셔도 됩니다.
웹 크롤링 파이썬 코드를 짜기 전에 물어볼 질문이 하나 있습니다. 이 데이터를 몇 년 동안 매일 받아야 하나요? 서비스에 붙일 데이터라면 화면이 바뀔 때마다 고칠 구조가 필요합니다.
설정과 적용 조건을 더 살펴보려면 robots.txt 표준 · Scrapy 수집 설정를 참고해 보세요.
수집한 데이터를 서비스에서 활용하려면
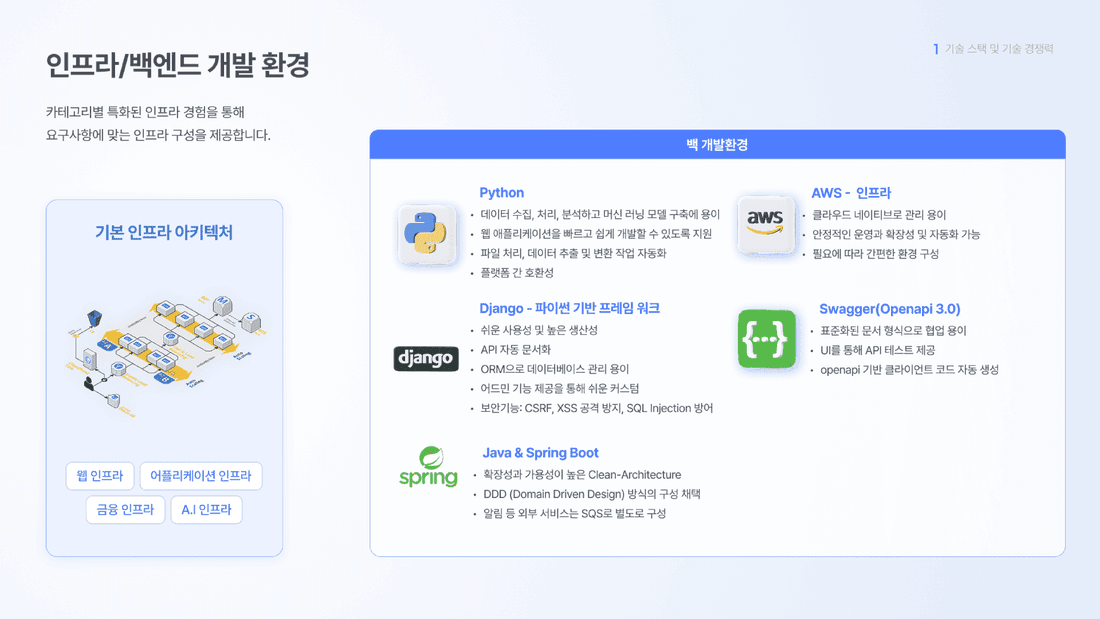
똑똑한개발자는 Python·Django 기반 백엔드와 관리자 시스템을 개발합니다. 수집한 데이터가 업무에 쓰이려면 저장 방식과 조회 화면, 업데이트 주기까지 이어져야 하는데요. 데이터 연동은 사용 가능한 공식 API와 이용 조건을 먼저 살펴 개발 범위를 구체화합니다.
데이터 수집을 업무 화면과 연결하고 싶으신가요? 아래 링크로 문의해 주시면 데이터 출처와 연동 방식, 필요한 조회 기능을 함께 검토하겠습니다.
감사합니다. :)
파이썬 수집 도구와 요청·응답 점검 방법을 알아봅니다.
https://www.toktokhan.dev/contact?utm_source=landing&utm_campaign=python-web-crawling&utm_medium=python-web-crawling&utm_term=%EC%9B%B9-%ED%81%AC%EB%A1%A4%EB%A7%81-%ED%8C%8C%EC%9D%B4%EC%8D%AC