RAG란? 검색 증강 생성의 원리와 구축 방법·비용
RAG란 LLM이 답하기 전에 외부 자료를 먼저 검색해 붙이는 방식으로, 2020년 NeurIPS 논문에서 제안됐습니다.
안녕하세요. 사랑받는 IT 프로덕트의 첫걸음, 똑똑한개발자입니다.
오늘의 인사이트 요약
RAG란 LLM이 답하기 전에 외부 자료를 먼저 검색해 붙이는 방식으로, 2020년 NeurIPS 논문에서 제안됐습니다.
RAG 구축 방법은 문서 정리, 벡터 DB 저장, 검색 품질 점검 순서이고 작은 자료 묶음은 모델의 입력 한도와 비용을 확인해 전체 입력 방식과 비교할 수 있습니다.
RAG 구축 비용은 총액보다 항목으로 봐야 하며 그래프 RAG는 문서 전체를 아우르는 질문이 많을 때 검토합니다.
RAG란 무엇인가, AI가 우리 회사 문서를 모르는 이유
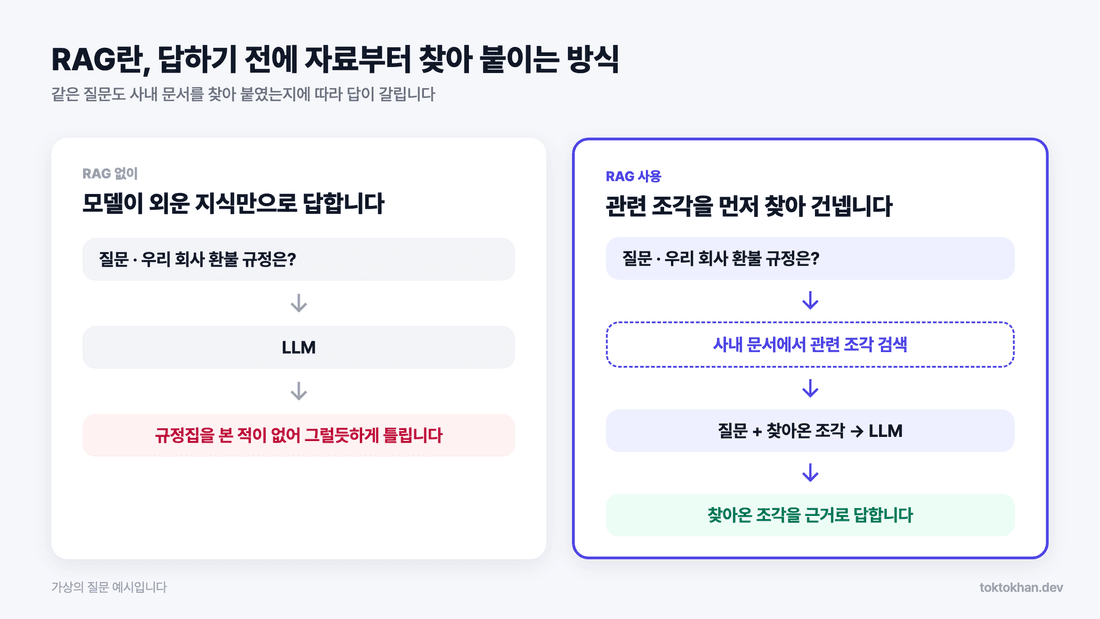
AI에게 우리 회사 환불 규정을 물어본 적 있으신가요. 최신 규정집이 모델에 제공되지 않았다면, 실제 회사 규정과 다른 답변이 나올 수 있습니다. 이 간극을 메우는 방식이 RAG, 검색 증강 생성(Retrieval-Augmented Generation)입니다.
RAG에서는 질문이 들어오면 모델이 답하기 전에 관련 자료를 먼저 찾아 질문과 함께 건넵니다. 이름은 2020년 Patrick Lewis 등의 NeurIPS 논문에서 왔습니다. 논문은 모델 가중치에 담긴 파라메트릭 메모리에 위키피디아 벡터 인덱스 같은 외부 메모리를 합쳤습니다.
앞서 다룬 MCP는 AI와 도구를 잇는 규격이었습니다. LLM RAG는 그 AI가 읽을 자료를 골라 건넵니다.
LLM RAG는 어떻게 답을 만들까, 세 단계로 보기
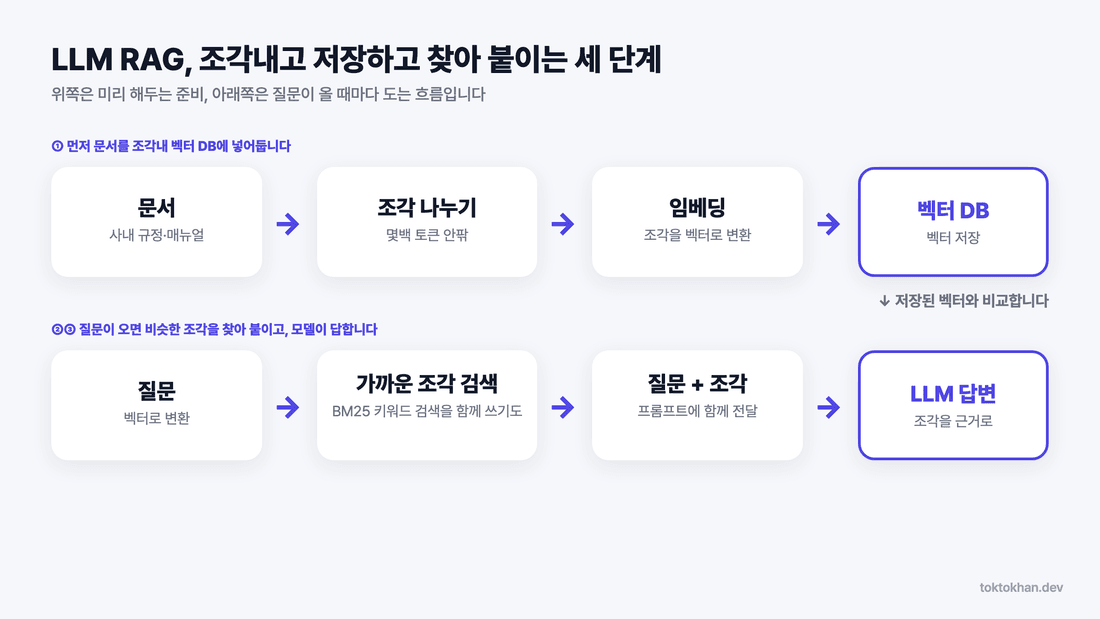
먼저 문서를 조각내 벡터 DB에 넣어둡니다.
문서를 몇백 토큰 안팎 조각으로 나누고 임베딩 모델이 각 조각을 숫자 목록인 벡터로 바꿉니다. 질문과 문서에 같은 임베딩 체계를 적용하면 벡터의 유사도를 검색에 활용할 수 있습니다. 벡터 DB는 이 벡터를 저장해 두었다가 가까운 것을 찾아줍니다. 전용 제품도 있고 오픈소스 pgvector처럼 Postgres에 얹는 방법도 있습니다.
질문이 오면 비슷한 조각을 찾아 붙입니다.
질문도 벡터로 바꿔 가까운 조각 몇 개를 꺼냅니다. 의미 검색은 제품 코드처럼 글자가 정확히 같아야 하는 검색에 약해서 Anthropic은 키워드 검색인 BM25를 함께 돌려 결과를 합치는 방법을 소개했습니다.
검색한 자료를 근거로 답변하도록 요청합니다.
RAG를 붙여도 정답이 보장되지는 않습니다. 오래된 문서, 잘못된 검색 결과, 모델의 해석 오류가 각각 영향을 줍니다. 답변에 문서명·해당 구절을 표시하고, 자료에 없는 내용은 확인되지 않았다고 답하도록 설계하면 결과를 검토하기 쉬워집니다.
RAG 구축 방법: 자료 범위와 검색 품질부터 정리합니다
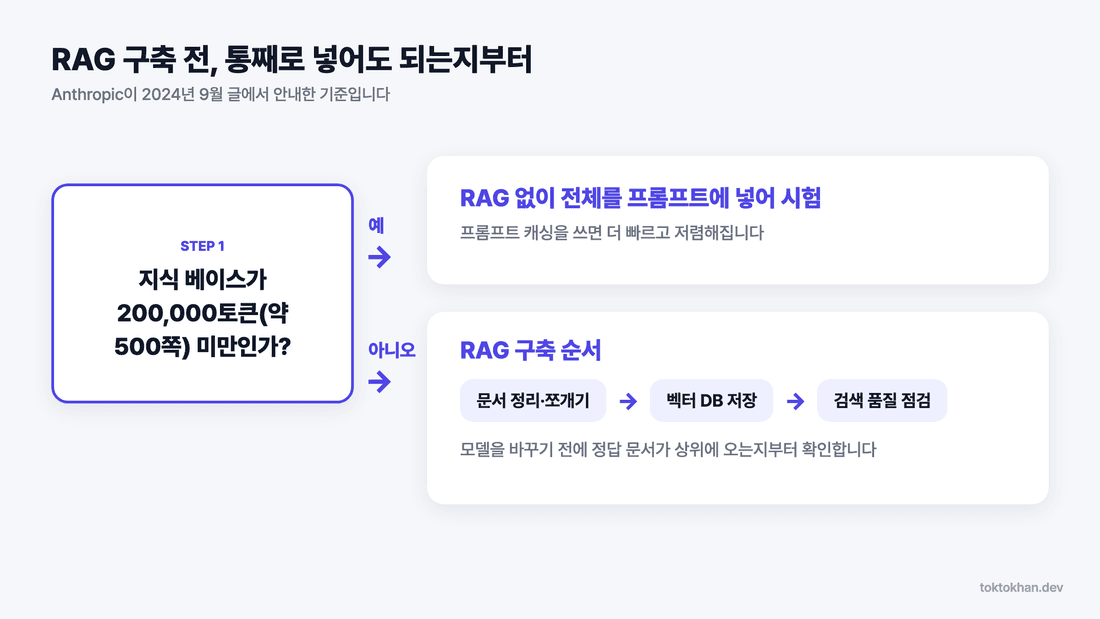
작은 자료 묶음은 전체 입력 방식과 비교할 수 있습니다.
위 도식의 200,000토큰은 Anthropic이 2024년 9월에 제시한 당시 예시입니다. 모든 모델에 적용되는 기준은 아닙니다. 실제로는 선택한 모델의 입력 한도, 답변에 남길 공간, 비용과 지연 시간, 문서별 열람 권한을 함께 비교합니다. Contextual Retrieval
둘째, 문서를 정리하고 쪼개는 일에서 시작합니다.
중복 파일이나 폐기된 규정이 섞여 들어가면 그것까지 검색됩니다. 최신본·작성일·관리자를 표시하고, 사용자가 볼 수 있는 문서만 검색 결과에 들어오도록 접근 권한을 적용합니다. 문서가 삭제되거나 권한이 바뀌었을 때 검색 인덱스에도 반영하는 흐름이 필요합니다.
셋째, 검색이 맞는지는 모델과 따로 점검합니다.
평가 질문과 정답 문서를 준비하면 검색 결과와 답변 생성을 나눠 확인할 수 있습니다. Anthropic의 2024년 실험에서는 맥락 설명과 키워드 검색, 재순위화를 조합해 검색 실패율이 줄었지만, 그 개선 폭이 다른 자료에서도 그대로 재현되는 것은 아닙니다. 실제 사내 질문으로 상위 결과의 정확도와 답변 근거를 평가합니다.
RAG 구축 비용은 어디에 들어갈까
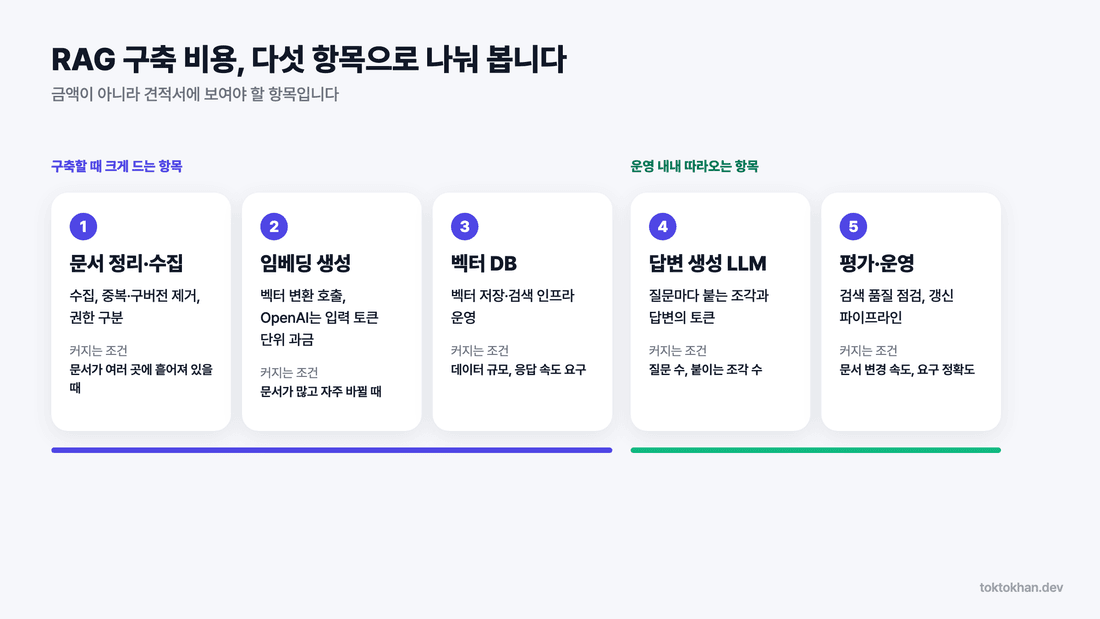
RAG 구축 비용은 자료 양과 갱신 주기에 따라 제각각입니다. 금액 대신 견적서에 보여야 할 항목을 나눠 봅니다.
비용 항목 | 무엇에 드는 돈인가 | 커지는 조건 |
|---|---|---|
문서 정리·수집 | 수집, 중복·구버전 제거, 권한 구분 | 문서가 여러 곳에 흩어져 있을 때 |
임베딩 생성 | 벡터 변환 API 또는 자체 모델 실행 | 문서가 많고 자주 바뀔 때 |
벡터 DB | 벡터 저장·검색 인프라 운영 | 데이터 규모, 응답 속도 요구 |
답변 생성 LLM | 질문마다 붙는 조각과 답변의 토큰 | 질문 수, 붙이는 조각 수 |
평가·운영 | 검색 품질 점검, 갱신 파이프라인 | 문서 변경 속도, 요구 정확도 |
구축할 때 크게 드는 건 앞 세 줄입니다. 답변 생성과 평가·운영은 서비스를 돌리는 내내 따라옵니다. 견적서에 RAG 구축 일괄이라고만 적혀 있으면 어느 쪽이 큰지 알 수 없습니다.
그래프 RAG는 벡터 DB 검색과 무엇이 다를까
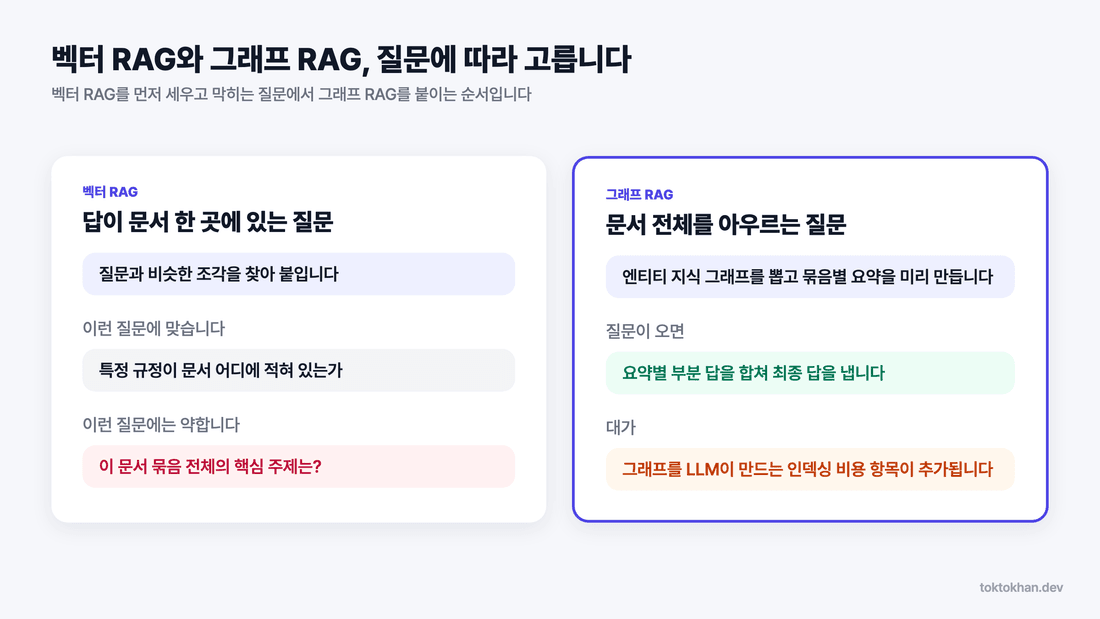
그래프 RAG는 관계와 전체 흐름을 먼저 정리해 둡니다.
벡터 검색은 답이 문서 한 곳에 있는 질문에 맞지만 이 문서 묶음 전체의 핵심 주제가 무엇이냐는 질문에는 가져올 조각이 정해지지 않습니다. 마이크로소프트 연구진(Darren Edge 등)은 2024년 4월 논문 "From Local to Global"에서 기존 RAG가 이런 말뭉치 전체 질문에 약하다고 지적했습니다. 대안으로 LLM이 문서에서 엔티티 지식 그래프를 뽑고 묶음별 요약을 미리 만들어 두게 했고 약 100만 토큰 규모 데이터셋에서 답변의 포괄성과 다양성이 높았다고 보고했습니다.
그래프 RAG의 대가는 인덱싱 단계에 있습니다.
그래프를 LLM이 만드니 위 비용 표에 항목이 하나 더 붙습니다. 마이크로소프트 공식 문서도 기본 설정만으로는 최상의 결과가 어려울 수 있다며 프롬프트 튜닝을 권합니다. GraphRAG는 사전 그래프 생성·요약 비용과 갱신 부담을 더해 검토합니다. 벡터 검색과 어느 방식이 유리한지는 질문 유형과 평가 결과로 비교할 수 있습니다. Microsoft GraphRAG 문서
자주 묻는 질문, 정답 문서, 최신본 기준을 함께 정리하면 RAG의 첫 평가 자료가 됩니다. 구축 규모는 이 질문에 답할 수 있는 작은 문서 묶음부터 확인하며 정할 수 있습니다.
회사 문서가 필요한 답변으로 이어지도록
사내 문서를 찾는 AI는 모델뿐 아니라 문서 관리 방식과 실제로 질문하는 사람의 업무도 닿아 있습니다. 똑똑한개발자는 AI 기능과 서비스 화면을 함께 설계하며, 자료가 어떻게 쓰일지부터 살펴봅니다.
자주 묻는 질문이나 정리해 둔 문서가 있다면 좋은 출발점이 됩니다. 우리 팀에서 쓰기 편한 문서 검색 서비스의 모습을 함께 그려볼 수 있습니다.
감사합니다. :)
프로젝트에 필요한 내용을 함께 살펴봅니다.
https://www.toktokhan.dev/contact?utm_source=landing&utm_campaign=rag-guide&utm_medium=rag-guide&utm_term=RAG%EB%9E%80