Jev AI 모델의 구조와 작동 방식 한 번에 보기
40~200배 빠르다는 Jev, 정말 LLM을 대체하게 될까요?
안녕하세요. 사랑받는 IT 프로덕트의 첫걸음, 똑똑한개발자입니다.
오늘의 인사이트 요약
Jev는 글을 쓰지 않는 AI 모델입니다. 보기 선택, 점수, 예 아니오 확률만 돌려주고 그 값은 사람을 거치지 않고 소프트웨어가 바로 받아 씁니다.
40~ 200배 빠르고 40~400배 저렴하다는 수치는 할 수 있는 일의 범위를 좁힌 결과입니다.
제조사가 공개한 4개 워크플로 정확도는 67.8%입니다. 판단 한 건의 단가와 지연을 내리는 데 쓸 모델입니다.
Jev AI 모델이 공개 일주일 만에 화제가 된 이유
Jev는 2026년 9월 15일 제한된 얼리 액세스로 공개됐습니다. 만든 곳은 2024년에 세워진 샌프란시스코 회사 TypeSafe AI인데 같은 시점에 벤처캐피털 DCVC가 이끈 4,000만 달러 시드 라운드를 발표했고 기업가치는 2억 달러로 평가됐습니다.
주목을 끈 건 숫자였습니다.
TypeSafe AI는 Jev가 기존 프런티어 모델보다 40~200배 빠르고 40~400배 저렴하다고 밝혔습니다. 공개 데모에서는 둠(Doom) 플레이 판단을 0.114초에 끝냈는데 같은 작업에 GPT-5.6 Terra는 8.566초가 걸렸습니다.
이 숫자만 보면 기존 LLM을 갈아치우는 모델처럼 읽힙니다.
그런데 Jev는 애초에 LLM과 다른 일을 합니다.
System One 모델은 기존 AI 모델과 무엇이 다른가
TypeSafe AI는 Jev를 System One 모델이라는 새 부류로 소개하는데 이 이름은 사람의 빠르고 직관적인 판단을 가리키는 시스템 1에서 가져왔습니다.
Jev는 문장을 만들지 않습니다.
입력은 프로그램 상태나 비정형 텍스트를 그대로 받고 출력은 자연어가 아니라 타입이 정해진 값입니다. 애초에 문자열 생성 기능이 없습니다. 사람이 읽을 답변을 쓰는 대신 다른 소프트웨어가 곧바로 받아 쓸 값을 돌려주기 때문입니다.
출력 형태는 Choice, Score, Noul 셋뿐입니다.
Choice는 미리 정한 보기 중 하나를 고르고 보기마다 확률을 붙입니다. Score는 0에서 100 같은 척도 위의 점수를, Noul은 예 아니오를 0과 1 사이 확률로 돌려줍니다. 질문 여러 개를 한 호출에 묶을 수도 있습니다. 고객 문의 하나를 넣고 분류와 긴급도를 한 번에 받는 식입니다.
확률을 정직하게 매기도록 학습시켰습니다.
학습에는 사람의 선호를 따라가는 RLHF 대신 RLCD(Reinforcement Learning for Calibrated Decisions)를 씁니다. 사람이 선호할 문장을 맞히기보다 확률을 정직하게 매기는 쪽으로 최적화했다는 설명입니다. 신뢰도 90%로 답했으면 실제 정답률도 그 근처에 붙어야 합니다. 그 성질이 학습 목표 안에 들어가 있다는 뜻입니다.
Jev AI 모델의 성능 수치를 어떻게 읽어야 하나
항목 | 기존 프런티어 LLM | Jev |
|---|---|---|
출력 형태 | 파싱해야 하는 생성 문자열 | 스키마가 보장하는 타입 값 |
생성 방식 | 토큰을 순서대로 예측 | 한 번의 병렬 처리로 전부 반환 |
응답 시간 | 수 초에서 수십 초 | 70~500ms, 평균 0.4초 |
입력 가격 | GPT-5.6 Terra 기준 100만 토큰당 2달러 | 100만 토큰당 0.042달러, 출력은 무료 |
구조화 출력 실패율 | 0.58~45.5% | 0% |
컨텍스트 | 수십만 토큰대 | 6만 4,000 토큰 |
표의 값은 TypeSafe AI 공개 자료와 외부 매체 실측을 섞어 정리했습니다만 항목마다 측정 조건이 달라 절대 비교보다는 경향으로 보시는 편이 안전합니다.
속도 차이는 구조에서 나옵니다.
LLM은 토큰을 하나씩 순서대로 뽑으니 답이 길어지면 시간도 길어집니다. Jev는 한 번의 병렬 처리로 정해진 값만 내놓아 답의 길이가 없는 셈입니다. IT 전문지 더 레지스터는 두 모델이 다른 문제를 풀고 있어 속도를 나란히 비교하는 것 자체가 오해를 부를 수 있다고 지적했습니다.
비용은 결정 한 건의 단가로 따져봅니다.
AI 워크플로 플랫폼 마인드스튜디오가 직접 돌려본 수치가 참고할 만합니다. 규칙 7개로 이메일 1,000건을 분류할 때 병렬로 6초, 0.09달러가 들었는데 같은 작업을 GPT-5.6급 모델로 돌리면 5분, 0.62달러였습니다. 유튜브 댓글 1,000건 분류는 5초에 0.05달러, 누적 2만 건 가까운 요청을 다 합쳐도 1달러를 넘지 않았습니다.
환각이 없다는 표현에는 조건이 붙습니다.
Jev가 스키마 밖의 값을 내놓지 못하는 건 사실이고 구조화 출력 실패율 0%는 설계에서 나온 성질입니다. 다만 더 레지스터는 출력이 자연어도 아닌 모델에 환각이 없다는 말을 붙이는 건 공정하지 않다고 봤습니다. 형식이 틀리지 않는다고 판단까지 맞는 건 아닙니다.
TypeSafe AI가 공개한 4개 워크플로 벤치마크 정확도는 67.8%였고 마인드스튜디오가 만든 비트코인 매매 봇은 첫 한 시간 성과가 좋지 않았습니다. 속도와 단가를 수백 배 줄여도 판단의 질은 따라오지 않습니다.
Jev AI 모델을 어디에 먼저 붙여볼 수 있나
같은 판단을 하루에 수천 번 반복한다면 첫 후보입니다.
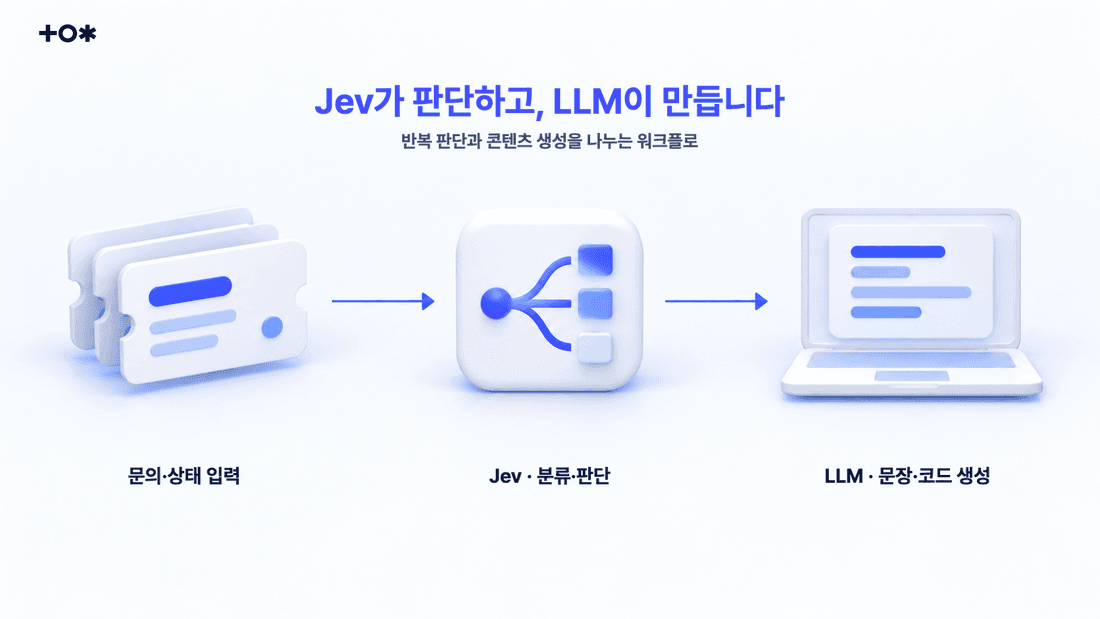
문의 티켓 라우팅, 스팸과 어뷰징 선별, 리드 점수 매기기가 여기 들어갑니다. 에이전트가 결과를 내놓았을 때 다음 단계로 넘길지 정하는 게이트도 같은 자리입니다. 지금까지 이런 판단은 LLM에 함수 호출을 붙여 억지로 구조화하거나 규칙 기반 분류기를 직접 만들어 처리했습니다. 판단 한 건의 지연이 0.4초로 내려가면 배치로 돌리던 일을 실시간으로 옮길 수 있습니다.
Jev가 아예 못 하는 일도 분명합니다.
글쓰기, 요약, 기획, 판단 근거를 말로 설명하는 일은 되지 않습니다. 컨텍스트가 6만 4,000 토큰이라 긴 문서를 통째로 넣는 방식도 맞지 않고 보기 개수는 255개까지만 다룹니다. 이미지 입력은 아직 없습니다.
현실적인 그림은 분업입니다. 상태를 보고 다음 행동을 고르는 자리에 Jev를 두고 그 결정을 받아 실제 문장이나 코드를 만드는 자리에 LLM을 둡니다. 저희는 이 경계를 나눠본 경험을 기준으로 System One 모델의 가치가 모델 교체보다 파이프라인 재설계 쪽에 있다고 봅니다.
Jev는 아직 얼리 액세스이고 안정 버전은 jev-1.13.0입니다. 지금 할 수 있는 준비는 기존 워크플로에서 판단만 떼어낼 수 있는 구간을 골라두는 정도입니다.
AX 도입, 프로젝트 협업 등 궁금한 점을 남겨주세요.
https://www.toktokhan.dev/contact?utm_source=landing&utm_medium=jev-ai&utm_campaign=ax-consulting-keyword&utm_term=jev-ai